「あの選手だけ見たい」をAIで実現する――少年サッカー映像とGPT‑6の実験
 UchinoKiyotaka
実験の始まりは、子どものチームメイトのお父さんが口にした、何気ない一言だった。
「試合映像から、特定の選手が映っているところだけ簡単にピックアップできたら良いよね」
少年サッカーの試合は、保護者が固定カメラやスマートフォンで撮影することが多い。しかし、30分以上の映像から自分の子どもが映っている場面を探し、必要な部分だけ切り出すのは意外に大変だ。そこで今回は、白いユニフォームの特定の背番号を見つけ、その選手が登場する場面を自動編集するプログラムを試作した。
ただし、その裏側は「動画をGPTへ渡して、10番を探してもらう」という単純なものではない。人物検出、追跡、画像処理、生成AI、データ保存、動画編集を順番に組み合わせた、小さな映像解析システムになっている。
この記事では、何をどの順番で処理したのか、どこで失敗したのか、GPT‑6、GPT‑5系、従来型OCRを比較して何が分かったのかを整理する。
動画をそのままGPTへ送ったわけではない
今回の処理は、大きく四つに分かれる。
- 映像から人物を見つける
- 同じ人物らしい画像を時間方向にまとめる
- 白ユニフォームと背番号を判断する
- 番号ごとの登場時間から動画を書き出す
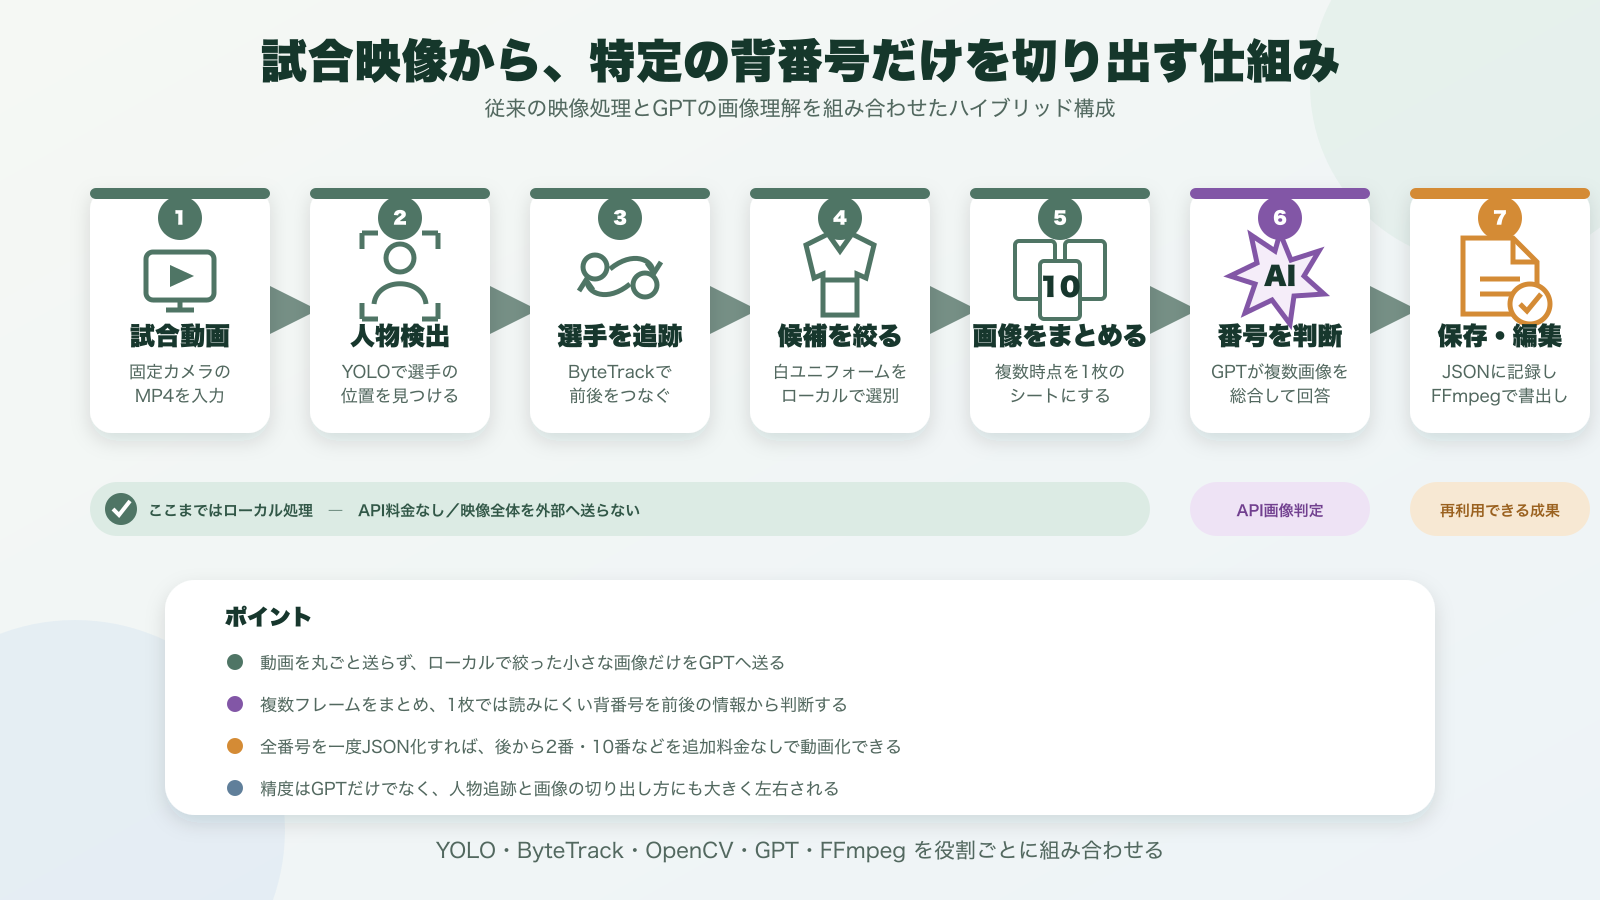
使用した主な技術は、Python、OpenCV、YOLO、ByteTrack、Pillow、GPT、JSON、FFmpegである。
| 技術 | 担当する処理 |
|---|---|
| OpenCV | 動画の読み込み、フレーム抽出、色判定 |
| YOLO | 画面内にいる人物の検出 |
| ByteTrack | 前後のフレームにいる同じ人物らしい対象の追跡 |
| Pillow | 人物画像の加工、コンタクトシート作成 |
| GPT | 白ユニフォームか、背番号は何番かの判断 |
| JSON | 背番号と登場時間の保存 |
| FFmpeg | 必要な区間の切り出しと結合 |
この役割分担が重要だった。大量のフレームを機械的に処理する仕事は従来技術へ任せ、曖昧な画像を見て判断する部分だけにGPTを使った。
まずYOLOで人物を見つける
試合動画は1秒間に約30枚の画像で構成されている。すべての画像を処理すると重くなるため、一定間隔でフレームを取り出した。
各フレームにYOLOを適用すると、画面内にいる人物の位置が四角形として返ってくる。この時点では、どちらのチームか、背番号は何番かまでは分からない。「この位置に人がいる」という検出だけである。
人物が小さい広角映像では、最初から背番号を読もうとするより、まず人物だけを確実に切り出した方が後段の処理を組み立てやすい。
ByteTrackが「同じ人らしい画像」をまとめる
次にByteTrackを使い、前後のフレームで位置や動きが近い人物へ同じトラックIDを付ける。
ここでいうトラックIDは、選手名や背番号ではない。雑に言えば「システムが同じ人物だと思ってまとめた画像のグループ」である。
理想は、1つのトラックIDに1人の選手だけが入ることだ。しかし実際には、選手同士が交差したり、手前の選手に隠れたりすると、追跡先が別の人へ切り替わる。反対に、同じ選手が一度画面から外れると、再登場時に別のIDが付くこともある。
この「同じ人を追い続ける」処理が、背番号認識以上に難しい部分だった。
トラックIDと比較サンプルIDは別物
この記事には、もう一種類のIDが登場する。後ほど紹介する「ID94」「ID119」はトラックIDではなく、比較実験用に付けたサンプルIDである。
両者の違いは次のとおりだ。
| 名称 | 例 | いつ付くか | 何を表すか |
|---|---|---|---|
| トラックID | track-0532、track-1137 | 人物追跡時 | ByteTrackが同じ人物らしいと判断した画像のまとまり |
| 比較サンプルID | ID94、ID119 | 比較用120件を抽出した後 | 比較表や画像を参照するための通し番号 |
| 背番号 | 2番、10番 | GPTやOCRの判定時 | ユニフォームに表示された実際の番号 |
処理上の関係は、次のようになる。
試合映像
  ↓
人物を検出・追跡
  ↓
一人分らしい画像へトラックIDを付ける
  ↓
トラックを必要に応じて時間で分割する
  ↓
コンタクトシートを作る
  ↓
比較実験用に120件を抽出する
  ↓
抽出した順番にサンプルID 0〜119を付ける
サンプルIDは、選手や人物を識別する番号ではない。「比較対象120件のうち、どの画像セットを指しているか」を示す整理番号にすぎない。
ここで、「比較サンプルIDが120個あるなら、のべ120人の選手がいるということか」と考えたくなるかもしれない。しかし、正確にはそうではない。
120という数字が表しているのは、120人ではなく、比較のために選んだ120個の追跡区間(画像セット)である。たとえば同じ2番の選手が、前半の別々の時間帯で5回検出されれば、実在する選手は一人でも、比較サンプルは5件になる可能性がある。反対に、追跡が途中で別選手へ切り替わると、一つのサンプルに10番と2番の二人が混ざることもある。
平たく言えば、試合映像から「誰か一人を追っているように見える短い映像クリップ」を120本取り出した、と考えるのが近い。
実際の選手A(2番)
├─ 3分付近の追跡区間 → サンプル1件
├─ 8分付近の追跡区間 → サンプル1件
└─ 15分付近の追跡区間 → サンプル1件
実際の人数:1人
比較サンプル数:3件
また、追跡ミスが起きた場合は次のようになる。
最初の1枚:10番
その後3枚:2番
        ↓
一つの追跡区間としてまとまる
        ↓
比較サンプル数:1件
実際に含まれる選手:2人
したがって、比較サンプル数から実際の選手人数を計算することはできない。120件は「のべ120人」ではなく、「背番号判定を120回行うために用意した120個の問題」と表現するのが最も分かりやすい。
今回の120件は、元の映像から作られたすべての候補ではない。1,144件の候補から、明確に見えるもの40件、不鮮明なもの40件、複数選手が混ざったもの40件を比較実験用に抽出した。サンプルID0〜119は、その120問へ付けた問題番号に近い。
たとえば比較サンプルID119の元データは、トラックID1137から作られたコンタクトシートである。ただし、そのトラックには白10番と白2番が混ざっていた。したがって、サンプルID119を「119番目の人物」と呼ぶのも、「一人の選手」と考えるのも正確ではない。
より厳密には、次のように表現できる。
比較サンプルIDとは、ある時間帯の一つの追跡結果から作られた、背番号判定用の画像セットに付けた管理番号である。
通常は一人の選手に対応することを期待しているが、追跡ミスによって複数の選手が含まれる場合もある。
白ユニフォーム候補をローカルで絞る
検出したすべての人物画像をGPTへ送れば、API料金と処理時間が大きくなる。そこで上半身付近の明るさと色の鮮やかさを調べ、白ユニフォームの可能性が高い画像だけを残した。
これはOpenCVによる単純な色判定である。白い服を完全に識別するものではなく、候補を減らすための一次選別だ。照明や肌、白線などにも反応する可能性があるため、最終判断には使わない。
候補画像には、拡大、コントラスト調整、輪郭の強調も施した。ただし、拡大すれば存在しなかった情報が復元されるわけではない。元映像で背番号が数ピクセルしかなければ、どう加工しても読めない場面は残る。
1枚ではなく、複数画像をまとめて判断する
サッカー選手は常に背中を向けているわけではない。正面、横向き、他選手との重なり、動きによるぼけが続き、その中の一瞬だけ番号が見える。
そこで、同じトラックIDに含まれる複数画像を時間順に並べ、一枚の「コンタクトシート」にまとめた。GPTには動画ではなく、このコンタクトシートを入力した。
1枚だけなら判読不能でも、前後の画像を合わせると「これは10番に見える」と判断できる場合がある。一方で、追跡ミスがあると、異なる選手の画像も一枚のコンタクトシートに混ざる。
GPTへ任せたのは、背番号の最終判断
GPTには、コンタクトシートごとに次の情報をJSON形式で返させた。
- 白ユニフォームか
- 背番号は何番か
- どの程度確信しているか
- 番号を採用するか
- そう判断した理由
重要なのは、GPTが人物検出や動画編集をしているわけではないことだ。GPTの仕事は、事前に整理された少数の画像を見て、背番号を判断する工程に限定した。
比較サンプルID119が示した「番号認識」と「人物追跡」の違い
比較サンプルID119は、この仕組みの難しさをよく表している。この「119」は選手やトラックの番号ではなく、比較用120件の通し番号である。元になったトラックIDは1137だった。
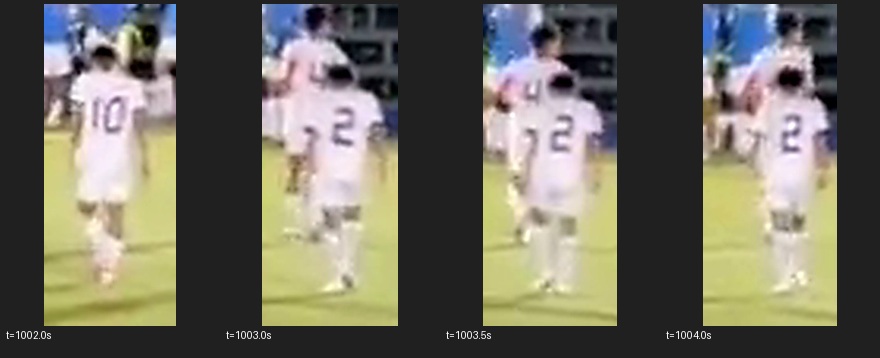
この画像では、最初のフレームに白10番、その後の3枚に白2番が写っている。番号そのものは比較的読みやすい。しかしByteTrackが両者を一人分のデータとしてまとめてしまった。
GPT‑6 Astraは、「最初は10番、その後は2番なので、途中で選手が切り替わっている」と判断し、番号を決めず保留した。GPT‑5.6 SolとTerraは、「3枚連続で中央に写る2番が主要な対象で、最初の10番は別選手」と判断し、2番を採用した。
これは単純に、どのモデルが数字を読めたかという話ではない。どのモデルも10と2を認識している。そのうえで、矛盾するデータを安全側に保留するか、多数の画像を代表として採用するかで結論が分かれた。
本来の改善策は、GPTへどちらかを選ばせることではない。10番から2番へ切り替わった地点で、トラックを二つに分割することである。精度のボトルネックが、GPTではなく人物追跡側にある例だ。
情報不足なら、どの方式でも読めない
比較サンプルID94では、赤い選手と白い選手が短時間に入れ替わり、白い選手も横・正面向きで背番号が見えなかった。この画像セットの元になったトラックIDは0532である。
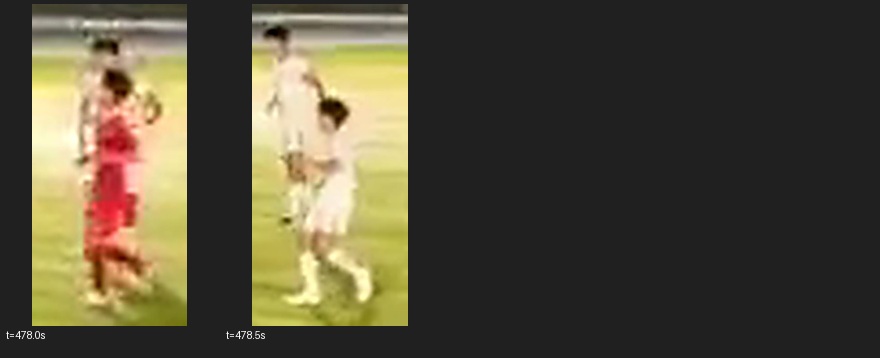
Astra、Sol、Terraはすべて保留した。OCRも数字らしい形へ弱く反応しただけで、採用には至らなかった。
高性能なモデルを使っても、元画像に番号の情報がなければ正解は作れない。この場合に必要なのは、さらに強いAIではなく、撮影解像度、カメラ位置、フレーム抽出間隔などの改善である。
GPT‑6、GPT‑5系、OCRを同条件で比較した
約16分44秒の1stHalf-1.mp4から、明確40件、不鮮明40件、別選手混在40件の計120件を抽出した。GPTの3モデルには、同じ画像、同じ指示、同じ20件単位のバッチ、同じ推論設定で新規に回答させた。GPTなし方式も、同じ120件をTesseract OCRで処理した。
| 方式 | 回答数 | 回答率 | 保留率 | 処理時間 | 費用 |
|---|---|---|---|---|---|
| GPT‑6 Astra | 59/120 | 49.2% | 50.8% | 約218秒 | 約1.06ドル |
| GPT‑5.6 Sol | 70/120 | 58.3% | 41.7% | 約272秒 | 約0.52ドル |
| GPT‑5.6 Terra | 58/120 | 48.3% | 51.7% | 約110秒 | 約0.23ドル |
| GPTなしOCR | 32/120 | 26.7% | 73.3% | 約209秒 | 0ドル |
明確な40件については、3つのGPTモデルがすべて回答した。差が出たのは、不鮮明な画像や別選手が混ざった画像である。Solは難しい候補でも積極的に番号を返し、Astraは矛盾があると保留しやすかった。
ただし、回答率は正解率ではない。積極的に答えれば回答率は上がるが、誤検出も増える可能性がある。今回の目的は、多少余分な場面が入っても対象選手を取りこぼさないことだった。その目的にはSolの性格が合っていた、というのが正確な表現になる。
全120件へ、モデルの回答とは独立した人手の正解ラベルを付けていないため、「Solが最も正確」とまでは断定できない。
同じモデルでも、回答は完全には固定されない
同じ画像と指示で再実行した結果、前回と今回の回答一致率は、Astra 85.0%、Sol 86.7%、Terra 94.2%だった。
生成AIの回答には一定の揺れがある。1回の実験だけで数ポイントの差をモデル固有の能力差と断定するのは危険だ。実運用するなら、再試行、確信度、モデル間合議、人による確認などを設計に含める必要がある。
GPTなしのOCRでは何が起きたか
GPTを使わない方式では、人物の胴体付近をグレースケール化し、コントラスト強調、鮮鋭化、二値化を行い、Tesseract OCRへ入力した。複数の前処理と複数フレームの結果を投票したため、単にOCRを1回実行しただけではない。
それでも、回答できたのは120件中32件だった。ユニフォームのしわ、腕、背景の線などを2、4、7と誤読する例も多かった。
OCRは文字の形を読む仕組みなので、「これは別選手の番号」「最初の1枚だけ違う人物」「番号が見えない正面画像は矛盾ではない」といった文脈を扱いにくい。人物が大きく正面または背面から映る映像なら有効だが、今回の広角映像では厳しかった。
一度解析すれば、別番号の動画は追加料金なしで作れる
判定結果は、背番号と登場時間をJSONへ保存した。
{
  "jersey_number": "10",
  "segments": [
    {"start": 188.0, "end": 205.0, "confidence": 0.98}
  ]
}
最初に全背番号を解析しておけば、後から「2番」「5番」「10番」と指定して登場区間を取得できる。この段階ではGPTを再度呼ぶ必要がない。
検出区間の前後には数秒の余裕を加え、近い区間を結合する。最後にFFmpegで元動画から各区間を切り出し、一本のMP4へまとめる。
AIによる判定と動画編集を分離し、中間結果をJSONとして残したことが、再利用しやすさにつながった。
瞬間的な判定にGPT‑6は必要か
今回のような「一枚のコンタクトシートを見て、背番号をJSONで返す」という限定的な仕事では、必ずしもGPT‑6 Astraを使う必要はないかもしれない。
SolはAstraより回答率が高く、費用は約半分だった。TerraもAstraに近い回答率を、約4分の1の費用と短い処理時間で示した。明確な画像を大量に処理するだけなら、低価格モデルで十分な可能性が高い。
一方、GPT‑6の価値は別の場所にあると考えられる。実際の開発では、動画を確認し、人物検出を調整し、追跡ミスの原因を調べ、プロンプトを直し、失敗区間を再解析し、JSONを検証して動画を書き出す。これは一問一答ではなく、多くの工程が連続する仕事だ。
GPT‑6 Astraは、個々の背番号判定よりも、こうした作業全体を見渡し、必要なツールとモデルを使い分けるディレクション役で真価を発揮するのかもしれない。
現実的には、次のような構成が考えられる。
- Astra:工程全体の管理、失敗検出、再解析の判断
- Sol/Terra:大量の定型的な背番号判定
- YOLO/ByteTrack:人物検出と追跡
- 人間:本当に判断できない難例だけ確認
高価なモデルをすべての処理に使うのではなく、仕事の難度に応じて配置する方が合理的だ。
まとめ――重要なのは、AIへ全部任せることではない
今回の試作で最も大きかった学びは、「最新AIへ動画を渡せば解決する」という話ではなかったことだ。
人物検出にはYOLO、追跡にはByteTrack、画像処理にはOpenCV、曖昧な判断にはGPT、記録にはJSON、編集にはFFmpegを使った。それぞれの技術を、得意な工程へ配置した結果として、背番号別の動画を作れるようになった。
また、誤りの原因もGPTだけではなかった。番号が見えない、人物が小さい、追跡先が切り替わる、異なる選手が一つのIDへ混ざる。システム全体を見なければ、本当の改善点は分からない。
モデル比較でも、「一番新しく高価なモデルを使えばよい」とは限らなかった。短く明確な判定では低価格モデルが有力で、長い工程の管理では上位モデルへ投資する意味が生まれる。
重要なのは、どのモデルが一番賢いかではない。この工程のどこに、どの能力を置けば、精度、費用、人の確認作業を含めた全体が最も効率よく進むかである。
始まりは「特定の選手だけ簡単にピックアップできたらいいよね」という一言だった。その素朴な要望を実現する過程は、生成AIを単独で使う実験ではなく、従来技術とAIをどう組み合わせるかを考える実験になった。
次に試してみたいのが、Geminiの動画理解を使う方法である。今回は人物画像を静止画として並べ、GPTに背番号を判断させたが、Geminiへ短い動画を直接入力すれば、選手の移動方向や入れ替わりといった時間的な情報も利用できる可能性がある。小さく不鮮明な背番号や長時間の個人追跡という課題がなくなるわけではないが、ID119のように途中で10番から2番へ対象が切り替わる場面では、静止画より正確に区間を分けられるかもしれない。
今後は、元動画を直接解析する方法と、YOLOで人物周辺を切り出した短い動画をGeminiへ渡す方法を比較し、今回のハイブリッド構成がどこまで変わるのか検証してみたい。